大模型人工智能本地部署成本与人工智能基础软件开发公司排名全解析
随着大模型技术的快速发展,越来越多的企业和开发者希望将大模型部署在本地环境中,以保障数据隐私、降低长期成本并实现定制化应用。本地部署大模型究竟需要多少投入?在人工智能基础软件开发领域,哪些公司处于领先地位?本文将围绕这两个核心问题展开详细分析。
一、大模型人工智能本地部署的成本构成
本地部署大模型的成本并非单一数字,而是由硬件、软件、人力、运维等多方面因素综合决定。总体可分为以下几类:
- 硬件成本:这是最主要的支出。大模型的推理和微调需要强大的GPU算力。例如,部署一个70亿参数规模的模型(如Llama 2 7B)进行推理,至少需要一张显存24GB以上的GPU(如RTX 4090或A10),成本约1-1.5万元;若要部署700亿参数模型(如Llama 2 70B),通常需要多张A100/H100 GPU,单卡价格在10-25万元,整机配置可达数十万至上百万元。还需配套服务器、存储、网络设备等,硬件总投入可从几万元到数百万元不等。
- 软件与授权成本:部分开源模型可免费使用,但若采用商业模型或需要企业级支持(如安全补丁、优化工具),则需支付授权费。推理框架(如TensorRT-LLM、vLLM)虽多为开源,但若使用云厂商的托管服务或商业版软件,也会产生费用。软件成本通常占比较小,但需考虑许可合规性。
- 人力与开发成本:本地部署需要专业的AI工程师进行环境搭建、模型优化、接口开发及系统集成。根据项目复杂度,可能需要1-5名工程师投入数周至数月,人力成本按人均月薪2-5万元计算,少则几万元,多则数十万元。若涉及领域微调或应用开发,成本更高。
- 运维与持续成本:包括电力消耗(高性能GPU功耗可达300-700W,电费可观)、机房冷却、硬件维护及模型更新等。每年运维成本约为硬件投资的10%-20%。
小型团队或个人开发者若仅部署轻量级模型(如7B参数)用于实验,总成本可控制在2-5万元;中小企业部署中等规模模型(如13B-70B参数)并集成到业务系统,通常需10-50万元;大型企业部署百亿/千亿参数模型或需要高可用集群,投资可达数百万元甚至上千万元。
值得注意的是,成本还受模型规模、推理并发量、响应延迟要求等因素影响。建议企业根据实际需求选择合适规模的模型,并优先考虑开源方案以降低授权费用。
二、人工智能基础软件开发公司排名(参考)
人工智能基础软件开发涵盖机器学习框架、深度学习平台、大模型训练与推理工具链等领域。以下为国内在该领域具有较强影响力的公司(排名不分先后,仅供参考):
- 百度:依托飞桨(PaddlePaddle)深度学习平台,提供全流程AI开发工具,并推出文心大模型系列,在基础软件生态建设上投入巨大。
- 阿里巴巴:推出魔搭(ModelScope)模型社区和PAI人工智能平台,支持大模型训练与推理,通义大模型体系覆盖多个参数规模。
- 华为:昇腾AI基础软硬件平台包括MindSpore框架和CANN算子库,注重全栈自主创新,在政府、企业市场应用广泛。
- 商汤科技:SenseCore大装置提供模型训练与推理服务,并开源了多模态大模型InternLM等,基础软件能力较强。
- 科大讯飞:星火大模型及配套开发平台,在语音和自然语言处理领域有深厚积累,提供AI开发工具链。
- 旷视科技:Brain++平台支持计算机视觉模型开发,开源了MegEngine框架,在基础软件层面有布局。
- 第四范式:主打企业级AI平台,提供自动化机器学习工具,帮助传统行业构建AI应用。
- 浪潮信息:推出源大模型及AI计算平台,在AI服务器和基础软件协同优化方面有优势。
- 智谱AI:专注于大模型研发,开源了GLM系列模型及开发工具,在基础模型软件层面活跃。
- 百度飞桨生态伙伴:如创新奇智、云从科技等,基于飞桨等平台开发行业解决方案,也参与基础软件生态建设。
选择人工智能基础软件开发公司时,需结合自身技术栈、行业需求及生态兼容性进行评估,而非单纯依赖排名。
三、与建议
本地部署大模型的成本从数万元到数百万元不等,关键取决于模型规模、硬件配置和团队能力。对于预算有限的企业,可先从中小模型入手,利用开源工具和云服务相结合的方式降低成本。在基础软件开发合作方面,建议优先考虑技术生态完善、开源贡献活跃的头部公司,同时关注其是否提供本地化部署支持。
随着模型压缩技术和硬件性能的提升,本地部署门槛将进一步降低。企业应持续跟踪技术动态,做出合理的投入决策。
最新产品
关于刘德兵先生2019年6月设立人工智能基础软件开发公司的商业计划书
人工智能基础软件开发 智能家居的智慧引擎与中关村硬创网的生态实践
人工智能时代的前端进化 从面向对象到智能基础软件开发
2025年软件开发行业人工智能应用趋势研究报告 人工智能基础软件开发
深入理论,浅出实践 北京人工智能沙龙助力软件开发培训新航向
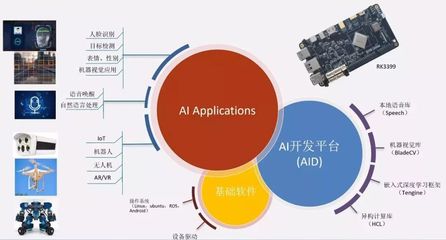
Arm中国人工智能基础软件开发 架构、生态与前瞻
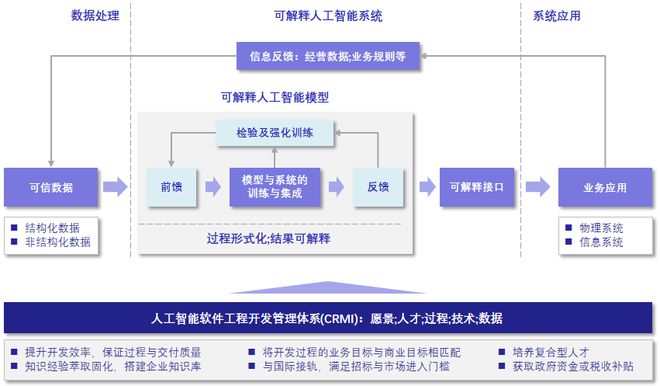
人工智能基础软件开发的关键基石 基于CRMI的软件工程能力成熟度探究
筑牢算力底座,创新软件生态——河南完善算力基础设施推动中原人工智能计算中心建设与基础软件发展
大模型驱动的新研发范式 重构软件开发的未来生态
制造业人工智能应用全景图 从产线革新到全链智能 —— 以人工智能基础软件开发为基石